Forget Suno... He Builds His Own AI INSTRUMENTS — With Dr. Hugo Flores
Dr. Hugo Flores explica VampNet, paletas sonoras próprias, Token Telephone e instrumentos de IA voltados ao design sonoro e à performance.
Da forma de onda a um instrumento de IA tocável
Transformar uma voz na textura de uma máquina de contar é uma ideia musical diferente de pedir a um serviço que gere uma música pronta. Nesta conversa, o Dr. Hugo Flores explica como constrói instrumentos a partir de uma paleta sonora escolhida, gestos gravados e interfaces que podem ser tocadas. Os exemplos passam por aprendizado de máquina, design de som, sampling e composição ao vivo. Também mostram por que a interface e o material usado para treinar um modelo importam tanto quanto o nome do modelo.
Flores explica a geração de áudio em duas etapas como uma resposta à escala do áudio digital. Em 44,1 kHz, um segundo contém 44.100 valores de amostra por canal. Um modelo que precisasse gerar cada amostra diretamente teria de lidar com uma sequência de altíssima dimensão. Os sistemas discutidos primeiro comprimem o áudio e depois geram nessa representação menor.
Um par encoder-decoder aprende a etapa de compressão. O encoder transforma as amostras de áudio em uma sequência de resolução menor; o decoder converte essa sequência novamente em som. Flores compara a ideia, de forma geral, à compressão MP3, mas ressalta que a representação é aprendida: o modelo determina quais informações manter para reconstruir o áudio. Ele chama a sequência compacta de tokens de áudio ou latentes. Na conversa, descreve-a como cerca de cem vezes menor do que a representação de áudio original.
A segunda etapa prevê ou gera tokens. Em alto nível, Flores compara o mecanismo a um modelo de linguagem: um controle, muitas vezes um prompt de texto em sistemas comerciais, orienta um modelo que produz uma sequência. O decoder transforma os tokens em áudio. No sistema de pesquisa apresentado, os modelos são treinados e executados nos computadores do laboratório; ChatGPT ou outro modelo de linguagem externo não gera o áudio. A comparação com modelos de linguagem é uma analogia para prever sequências, não significa que o sistema de áudio seja simplesmente um chatbot.
VampNet: mascarar tokens e preencher as lacunas
O principal exemplo generativo da entrevista é o VampNet, um modelo musical que, segundo Flores, preenche trechos ausentes em uma sequência de tokens. Começa-se com um áudio existente e faz-se sua codificação. Em seguida, alguns tokens são mascarados, deixando lacunas na sequência, e o modelo tenta prever o que estava ali. A fonte não é uma página em branco: o áudio ao redor oferece contexto para a reconstrução.
Flores demonstra o processo com uma gravação de “Billie Jean”. Depois da compressão, partes da sequência de tokens são removidas. A versão mascarada soa fragmentada; então o VampNet preenche os espaços com sua melhor aproximação, baseada no que aprendeu durante o treinamento. Isso se aproxima mais de transformar ou reconstruir material existente do que de compor uma música inteira do zero.
O resultado reflete os dados de treinamento. Flores diz que o modelo pré-treinado geral foi treinado com uma grande variedade de músicas. Como prevê continuações plausíveis, tende aos padrões comuns nesse material. Ele caracteriza o som padrão como amplo e pop, ou médio. A questão não é que toda geração soe igual, mas que a distribuição aprendida pelo modelo influencia o que ele considera uma continuação provável.
Seu fluxo criativo muda essa tendência com fine-tuning. Ele começa com o modelo pré-treinado, que aprendeu estruturas gerais do áudio, e depois oferece uma paleta específica para que o modelo reflita aqueles sons. Não quer que a saída se pareça com a música de outras pessoas. Nas obras e instalações discutidas, ele próprio escolhe os materiais de origem e ajusta o modelo com os sons coletados.
A máquina de contar: voz como contorno, máquina como textura
A demonstração da máquina de contar torna essa diferença concreta. Flores encontrou na internet uma gravação de uma máquina de contar cujo som lhe agradou e a usou como material para uma paleta. Depois, oferece a própria voz como gesto de entrada. A voz fornece um contorno que muda; o VampNet ajustado reconstrói esse contorno com o caráter mecânico da máquina.
É útil separar as duas funções. A entrada não é apenas um prompt dizendo “faça uma máquina de contar”, e a gravação mecânica não é simplesmente reproduzida sem mudanças. O modelo aprendeu uma textura a partir do material escolhido e usa essa paleta para preencher partes mascaradas da sequência de tokens derivada da voz. A saída depende, portanto, tanto do que é performado quanto do que o modelo aprendeu a reconhecer como som possível.
Flores descreve uma paleta sonora como algo entre cerca de cinco minutos e quatro, ou até oito, horas de sons gravados ou coletados. Essa faixa representa suas explorações, não uma especificação mínima para todo projeto. A quantidade e o caráter dos dados devem combinar com a transformação desejada. Ele também aproxima essa prática do sampling: sabe quais gravações e obras selecionou e considera importante reconhecer essas fontes. Um conjunto de dados próprio é uma decisão artística e traz consigo questões de escolha e procedência.
Token Telephone transforma feedback em escuta
Token Telephone, uma instalação criada com Stefan Moore, leva a transformação adiante: a saída é devolvida ao modelo como entrada seguinte, repetidamente. Cada passagem altera um pouco o som. Ao longo de muitas passagens, as mudanças se acumulam, permitindo ouvir as direções ou “ressonâncias” preferidas pelo modelo. O processo revela não apenas um ponto final, mas uma trajetória do som inicial em direção a padrões que o modelo processa com segurança.
Flores descreve um teaser feito com o modelo geral, treinado com uma ampla coleção musical. Depois de aproximadamente vinte minutos, pontos de partida muito diferentes — incluindo fala e ruído — muitas vezes se aproximam de um acorde de piano suave e relativamente estático. O caminho exato pode variar, mas o destino recorrente torna audível a média aprendida pelo modelo. Em outras demonstrações, uma consoante ou sílaba pode virar um gesto rítmico curto, como um rufo semelhante a chimbal.
A instalação já usou vários modelos ajustados para que visitantes ouçam a própria voz se transformar. Um modelo de ópera aproxima a fala de texturas operísticas; modelos de coro e orquestra levam a outras transformações. Flores diz que selecionou cerca de três horas de suas músicas corais favoritas para a paleta do modelo de coro. Ele descreve uma voz gravada passando por transformações repetidas até assumir um caráter coral. A comparação mostra por que paletas diferentes geram resultados distintos mesmo em uma configuração de feedback semelhante.
Neural Tape Loop: gravar primeiro, depois tocar a transformação
Neural Tape Loop parte de uma limitação do VampNet. Flores não apresenta o VampNet como um efeito de streaming que processa continuamente uma entrada ao vivo com latência desprezível. Em vez disso, grava-se um som para depois transformá-lo. Ele compara o fluxo à fita: primeiro se grava o material; depois ele pode ser cortado, remodelado ou manipulado. O modelo pode fatiar a gravação e acrescentar material de seu conjunto de dados aprendido, mas a pessoa trabalha com trechos gravados em vez de tratá-lo como um efeito convencional inserido em tempo real.
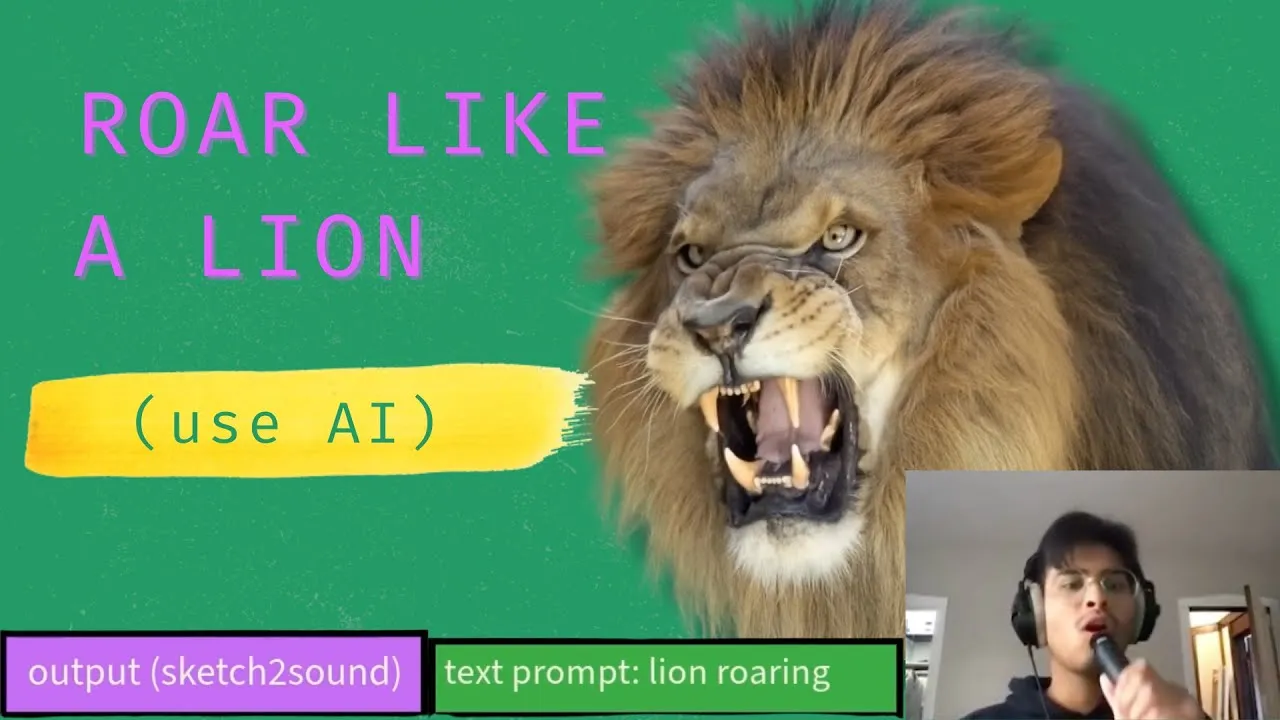
A interface de performance tem oito interfaces de modelo, cada uma funcionando como uma pista, além de um mixer. Flores pode construir uma cena gerando elementos separados, combinando-os, mudando seus níveis e fazendo crossfades. Alguns elementos vêm de prompts de texto. Entre os exemplos demonstrados estão digitar “teclado digitando”, pedir o rugido de um leão e gerar bolhas. Outros materiais podem vir de voz ou de sons acústicos. Ele combina essas fontes em vez de tratar um único prompt como uma composição pronta.
Na configuração quadrifônica, panners movimentam os sons pelo espaço de escuta. Esse movimento espacial, junto da mixagem e do tempo, dá ao músico controle sobre como fragmentos gerados formam uma paisagem sonora ao vivo. O nome “tape loop” representa tanto a lógica de gravar e transformar quanto o caráter exploratório, às vezes trabalhoso, que Flores associa ao processo. É um instrumento para manipular material gerado, não uma promessa de resposta instantânea de todos os modelos.
Max, Python e um computador separado com GPU
A interface do Neural Tape Loop roda no Max, mas é apenas a frente do sistema descrito por Flores. O patch do Max se comunica com um script Python no laptop dele. Esse script envia uma solicitação para outro processo Python, executado em um computador com GPU de categoria gamer; essa máquina roda o modelo e devolve o áudio gerado. A interface coordena várias partes, em vez de conter sozinha os pesos e todo o processamento do modelo.
Flores diz que o VampNet é pequeno o bastante para rodar em uma única GPU de um computador gamer e cita uma máquina com RTX 3080 como exemplo. Mesmo assim, a configuração tem várias etapas e depende da disponibilidade do outro computador e da rede. Antes de uma apresentação, ele se preocupa se a máquina no laboratório dele em Chicago está funcionando e conectada. Ele menciona serviços de GPU hospedada como possibilidade de disponibilizar modelos remotamente, mas não anuncia um serviço comercial pronto. Para músicos, a distinção importa: o patch do Max sozinho não é o instrumento completo; a instalação demonstrada depende dos processos Python e do sistema com GPU.
RAVE e BRAVE: um caminho mais próximo da resposta em tempo real
Para quem começa com menos poder de processamento, Flores aponta o RAVE, um autoencoder variacional em tempo real. Na estrutura de duas etapas, o RAVE se aproxima mais da primeira: comprimir e reconstruir áudio. Em vez de pedir apenas que reproduza fielmente a entrada, é possível manipular esse processo de reconstrução para transformar o timbre. Flores o considera mais limitado que o VampNet, mas vê espaço para exploração e observa que pode rodar localmente, sem um servidor separado. Ele descreve um patch de Max e um componente externo instalável, tornando-o uma maneira comparativamente acessível de experimentar instrumentos com aprendizado de máquina.
Ele também fala do BRAVE, um desenvolvimento mais rápido associado na conversa a Franco Caspe. Flores diz que o ganho de velocidade melhora bastante a resposta à entrada de áudio, especialmente ao transformar beatbox em bateria. Na demonstração, a voz é convertida em sons de bateria em tempo real. Ele descreve a latência como próxima de zero, mas não apresenta medição numérica; trata-se de sua avaliação qualitativa da interação, não de um benchmark.
Essa resposta rápida traz uma troca nos dados. Um modelo focado em voz para bateria precisa de uma coleção de sons limpos de bateria, robusta e escolhida cuidadosamente; Flores contrasta isso com simplesmente juntar cinco minutos de música favorita. Ele menciona cerca de duas horas de material de bateria selecionado com cuidado como uma paleta possível para essa tarefa. Os dados precisam combinar com o objetivo da transformação, e a baixa latência não elimina o trabalho de escolher e preparar sons de origem.
Crie uma interação que sirva à sua música
A conversa apresenta brevemente o Stacco, instrumento de Nicola Bátó, como exemplo de interação física com um modelo de aprendizado de máquina. Uma placa contém sensores magnéticos; mover ímãs sobre ela altera a representação latente do modelo e, por consequência, a trajetória do som. Flores gosta de como forças e gestos físicos agem diretamente sobre uma representação abstrata. Ele descreve isso como uma forma gestual de tocar o modelo, em vez de apenas digitar em uma caixa de texto.
O conselho mais amplo é fazer música com esses sistemas, avaliar se o resultado parece ter autoria e levá-lo a apresentações ou a outras pessoas. Escolher entre uma transformação baseada em gravação, um instrumento de voz para bateria ao vivo e um controlador de gestos magnéticos é uma escolha sobre interação e tempo. Flores também menciona pedais de guitarra com Daisy Seed e um sintetizador dub siren, mas são outros projetos, não instruções detalhadas de montagem nesta conversa. Para esta entrevista, a lição de design é começar pela ação musical que se quer executar e então escolher modelo, paleta sonora e interface que a tornem possível.